一份经签署的计算书必须可复现。如果有人一年后重新打开项目,或者另一位工程师来审核,同一个模型必须得出同样的数值,并且必须清楚是哪个版本的程序算出了这些数值。
我们实际测量后发现,这一点并不总是成立:同一个模型在一次会话中求解两次,末几位数字可能不同,有些结果的输出顺序也不一样。差异很微小,但在什么都没变的情况下发生变化的数值,是无法检验的。
差异从何而来
引擎把节点、杆件、支座和荷载保存在哈希表中,而每个表创建时都使用随机种子:同一个文件读取两次,遍历的顺序会不同。以另一种顺序累加浮点数,可能改变最后一位,因为计算机中的加法不满足结合律。3D 装配器本来就对杆件排序,但 2D 装配器、荷载与支座的循环以及大多数其他分析并没有排序。
- 现在对输入表的每一次遍历都按固定顺序进行,即按键的顺序:引擎中共 587 处。
- 平衡求和以及斜支座的交叉项同样按固定顺序遍历。
- 警告按节点或杆件编号排序输出,不再随机。
| 内容 | 数量 |
|---|---|
| 改为固定顺序的输入表遍历 | 587 |
| 逐位比较的各随机模型读取次数 | 6 |
一项测试对每个随机模型读取六次并求解,把结果当作文本逐位比较,涵盖线性分析、模态分析、屈曲分析和 P-Δ 分析。凡是改变了结果的无序遍历,都会表现为各次运行之间的差异。
每份报告都注明来源
现在,每份计算书、PRO 报告、工作簿和 CSV 都带有一个溯源块:应用和引擎的版本与提交,完成求解的 WebAssembly 模块的 SHA-256 指纹,精确模型、设置和所示结果的指纹,以及证书的状态(移动荷载包络记录得较少:只有其模型和设置)。如果导出准备期间项目发生了变化,则不会导出任何内容:报告绝不会把一种状态下的数值放在另一种状态的溯源之下。
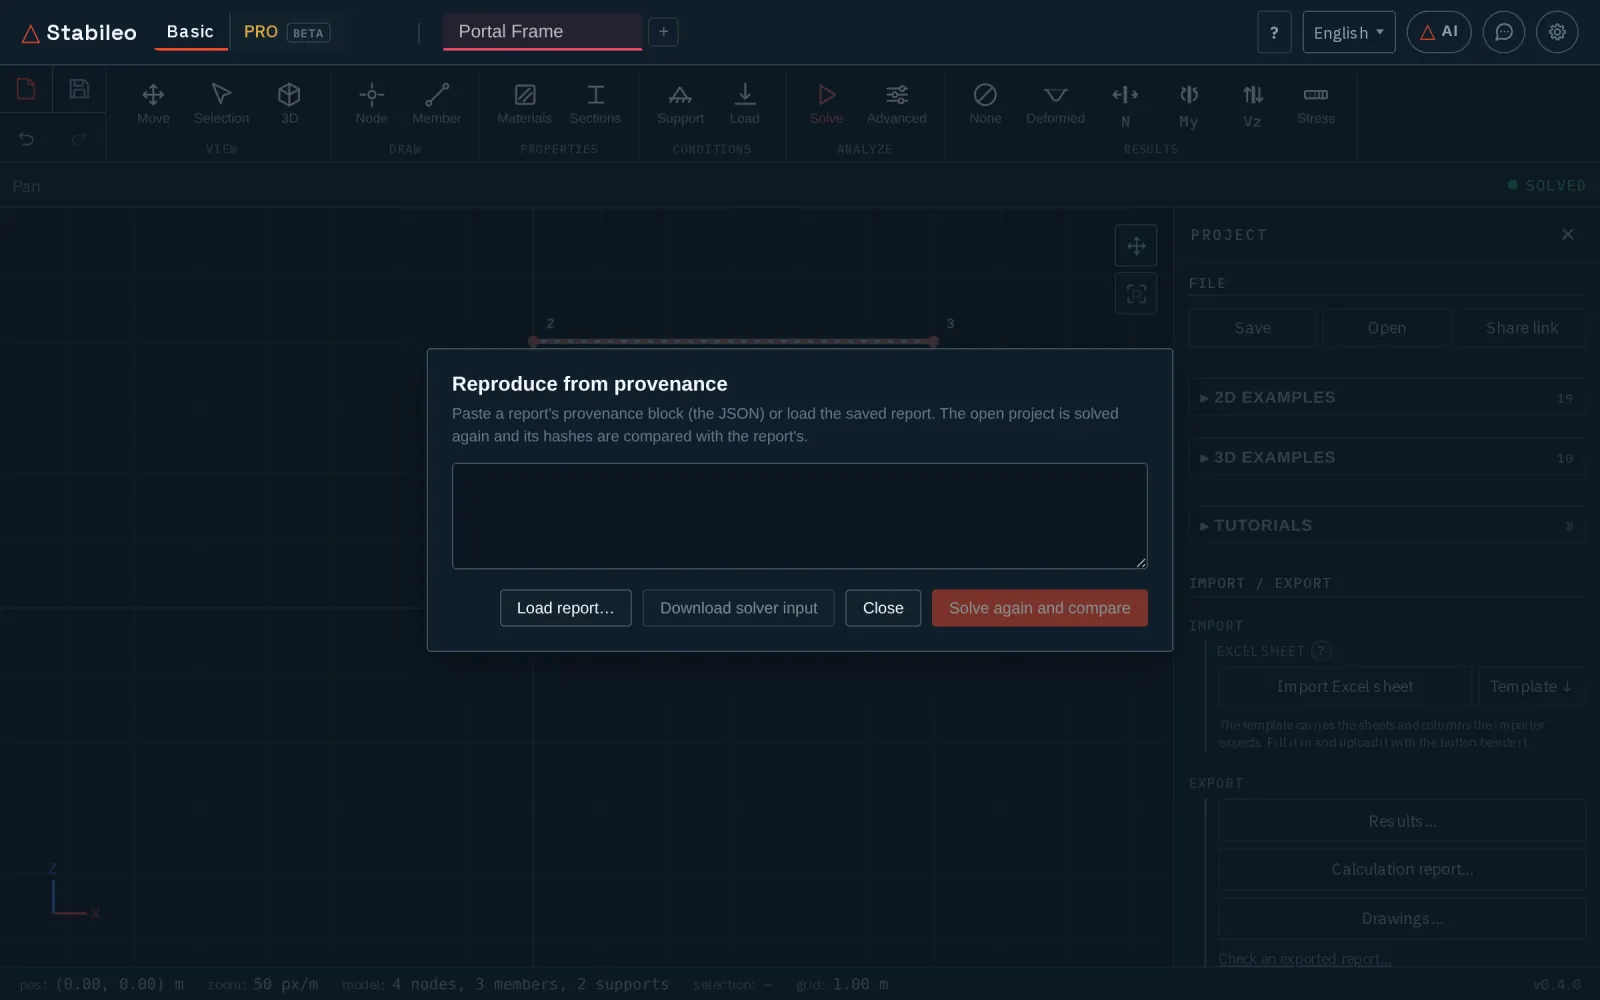
有了这个块,应用就能复现一份报告:它重新求解项目并比对每一个指纹。只有全部吻合时,结论才是“已复现”(不同的 WebAssembly 构建会在旁边注明,不算作差异);若有指纹无法重新计算,则显示“不完整”,绝不会显示“已复现”。另外还有一个命令行工具,对同一输入求解两次并核对指纹。
旧项目会自行说明
每个已保存的项目都记录求解时所用的结果版本。当打开一个在某项与其功能相关的变更之前求解的项目时,应用会列出这些变更,并用您的语言说明,同时在重新求解之前将结果标记为过时。有疑问时,变更按适用处理:多一条通知只耽误一分钟,少一条则可能掩盖一个已经变动的数值。
一项局限
应用始终是以 WebAssembly 与 WebAssembly 比较。原生工具在测试模型上与浏览器的指纹逐位一致,但三角函数在各平台来自不同的库,因此,若某个模型的装配以两者舍入方式不同的方法使用了三角函数,命令行与浏览器的结果在最后一位上可能不同。